Un RAG local ne donne pas une mémoire magique à un modèle d’intelligence artificielle. Il cherche des passages dans une collection de documents, puis les ajoute au contexte d’une requête. Bien conçu, il aide à retrouver une source et à répondre sur un corpus privé. Mal conçu, il fournit des extraits hors sujet avec beaucoup d’assurance.
Je préfère le considérer comme un moteur de recherche assisté par un LLM. Cette définition simple permet de séparer ce qui est réellement indexé, ce qui est retrouvé et ce que le modèle invente encore.

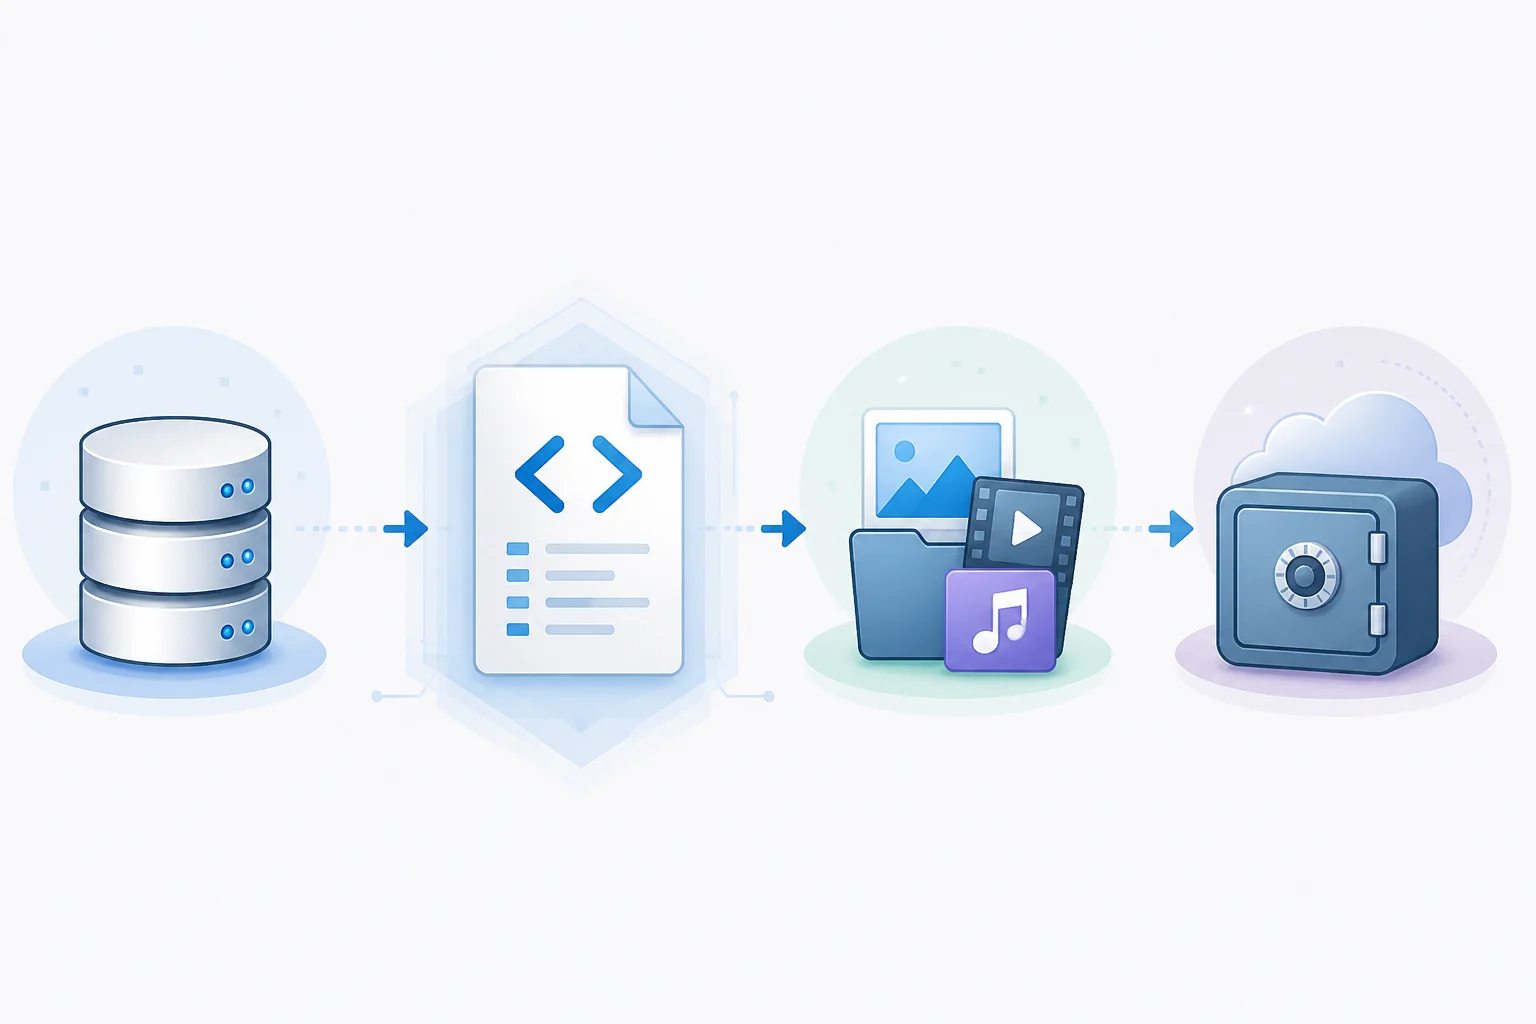
RAG local : les quatre étapes à ne pas confondre
- préparer les documents : extraction du texte, nettoyage et découpage ;
- représenter les passages : création d’embeddings ou d’un index lexical ;
- retrouver les candidats : recherche des extraits proches de la question ;
- générer la réponse : insertion des extraits dans le contexte du LLM.
Chaque étape peut échouer indépendamment. Un excellent modèle ne répare pas un PDF mal extrait. Un index précis ne garantit pas qu’une réponse citera correctement le passage.
Ce que le RAG fait bien
Le RAG est utile quand l’information existe déjà dans un corpus identifiable : documentation technique, procédures, notes, contrats, catalogues ou archives. Il évite de réentraîner le modèle pour chaque mise à jour et permet d’afficher les sources consultées.
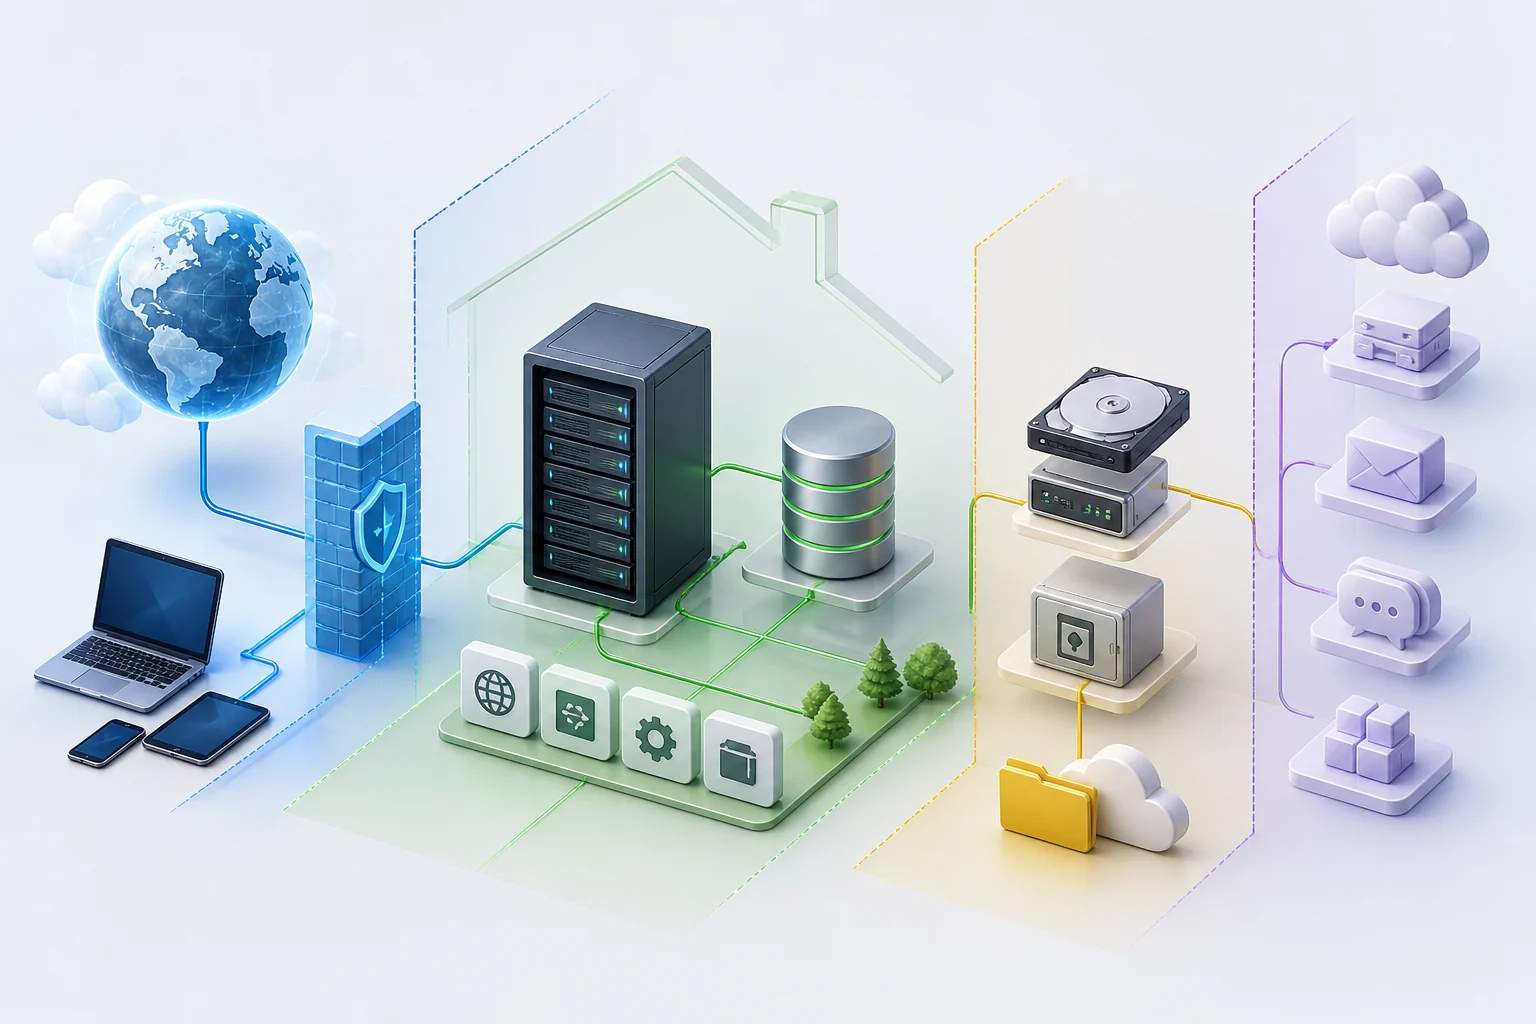
En local, il ajoute un avantage de maîtrise : les documents peuvent rester sur la machine ou le réseau privé. Cela ne suffit pas à assurer la confidentialité ; l’interface, les journaux, les sauvegardes et les composants externes doivent aussi être contrôlés.
Ce qu’il ne fait pas
- il ne transforme pas une source erronée en vérité ;
- il ne garantit pas que le meilleur passage sera retrouvé ;
- il ne supprime pas les hallucinations du modèle ;
- il ne comprend pas automatiquement les tableaux, scans et mises en page complexes ;
- il ne remplace pas les droits d’accès document par document ;
- il ne maintient pas l’index sans processus de mise à jour.
Le papier fondateur sur la Retrieval-Augmented Generation décrit l’association entre mémoire paramétrique et mémoire externe. Dans un projet concret, cette idée devient une chaîne de composants qu’il faut tester.
Le découpage décide d’une grande partie du résultat
Un document entier est souvent trop long et imprécis. Des fragments minuscules perdent le contexte. Je découpe selon la structure : titres, paragraphes, articles ou sections. J’ajoute un léger chevauchement lorsque deux idées traversent une frontière.
Je conserve avec chaque passage le nom du fichier, la date, la section, la version et les droits d’accès. Ces métadonnées permettent de filtrer avant la recherche et d’afficher une citation utile.
Recherche vectorielle, lexicale ou hybride
La recherche vectorielle rapproche des formulations de sens voisin. Elle peut retrouver « alimentation de secours » pour une question sur un onduleur. La recherche lexicale reste forte sur les références exactes, codes d’erreur, noms propres et numéros de version.
Une stratégie hybride combine souvent les deux. Je commence néanmoins par une base simple et mesurable. Ajouter un reranker, plusieurs index et des agents avant d’avoir évalué la recherche initiale rend le diagnostic plus difficile.
Construire un jeu de questions réaliste
Je prépare au moins trois catégories :
- questions dont la réponse apparaît clairement dans un passage ;
- questions qui exigent de combiner deux sections ;
- questions auxquelles le corpus ne répond pas.
La troisième catégorie est indispensable. Un bon système doit savoir dire que l’information manque. Je vérifie d’abord si le passage utile est présent dans les résultats, puis si la réponse respecte ce passage. Mélanger ces deux mesures empêche de savoir si l’erreur vient de la recherche ou du modèle.
Le rôle du contexte et de la mémoire
Injecter dix longs extraits augmente la consommation et peut diluer l’information importante. Le guide BlackFury sur la VRAM, la RAM et le contexte d’un LLM local explique pourquoi une grande fenêtre n’est pas un objectif en soi.
Je demande au système de citer le fichier et la section, puis de séparer les faits extraits des inférences. Si aucune source ne soutient une phrase, elle doit être présentée comme hypothèse ou supprimée.
Gérer les documents qui changent
Un RAG local devient obsolète si son index ne suit pas les versions. J’attribue un identifiant stable à chaque document, je retire les fragments de l’ancienne version et je journalise la date d’indexation. La suppression doit aussi se propager aux copies et sauvegardes selon la politique retenue.
Pour un petit corpus, une réindexation complète peut être plus sûre qu’une synchronisation complexe. Pour un volume important, je contrôle les ajouts, modifications et suppressions avec un rapport d’erreurs.
Sécurité : le document est aussi une entrée
Un fichier peut contenir des instructions destinées à détourner le modèle. Je traite donc le contenu récupéré comme une source non fiable, pas comme une consigne. Les règles du système restent séparées, et les actions sensibles ne doivent jamais être déclenchées uniquement par un texte retrouvé.
Les permissions sont appliquées avant la recherche. Un utilisateur ne doit pas recevoir un extrait interdit puis compter sur le modèle pour l’ignorer.
Ma méthode minimale de validation
- extraire visuellement un échantillon de chaque type de fichier ;
- vérifier la taille et les frontières des fragments ;
- tester vingt questions connues et cinq questions sans réponse ;
- mesurer le rappel du passage utile dans les premiers résultats ;
- vérifier les citations et les refus justifiés ;
- modifier puis supprimer un document et contrôler l’index ;
- tester les droits d’accès avec deux profils différents.
RAG local ou simple recherche ?
Si l’utilisateur veut seulement retrouver un fichier ou une référence exacte, une recherche classique peut être plus rapide et plus fiable. Le LLM devient utile lorsqu’il faut résumer plusieurs passages, reformuler ou guider la lecture. Il ne doit pas masquer le moteur de recherche ni les sources.
L’article BlackFury sur les gains et coûts cachés de l’IA locale aide à intégrer l’indexation, le stockage et la maintenance au bilan réel.
Verdict BlackFury
Un RAG local est un système documentaire, pas un bouton « ajouter une mémoire ». Sa qualité dépend du texte extrait, du découpage, de la recherche, des métadonnées, des droits et de l’évaluation. Je préfère un petit index compréhensible avec des citations vérifiables à une usine à agents qui répond vite sans montrer d’où vient l’information.